
<잇(IT)터뷰 전체 영상 보기>
잇(IT)터뷰 전체 내용은 ▼아래 영상▼에서 확인해 주세요!
◼ 게스트 : 이인섭 차장 / eG Innovations, 유병국 이사 / 굿모닝아이텍(goodmkt@goodmit.co.kr)
◼ 진행자 : 고우성 PD / 토크아이티 (talkit@talkit.tv, https://talkit.tv/)
<잇(IT)터뷰 – 핵심 내용 파악하기>
‘잇(IT)터뷰 – 핵심 내용 파악하기’는 영상의 핵심 내용을 정리한 글입니다.
|
“VDI가 느립니다.”
사용자의 이 한마디만으로 원인을 찾기는 쉽지 않다. VM의 CPU가 부족한 것인지, 애플리케이션이나 네트워크에 문제가 있는지, 아니면 전혀 예상하지 못했던 스토리지에서 문제가 발생했는지 여러 영역을 확인해야 하기 때문이다. 특히 인프라 비용이 높아진 상황에서는 성능 문제가 발생할 때마다 서버나 메모리를 증설하는 것도 부담이다.
결국 중요한 것은 VDI 환경 전체를 연결해서 보고 장애의 근본 원인을 빠르게 찾는 동시에 현재 자원을 얼마나 효율적으로 사용하고 있는지 파악하는 것이다.
1. VM 외부의 지표만으로는 VDI 장애의 진짜 원인을 찾기 어렵다
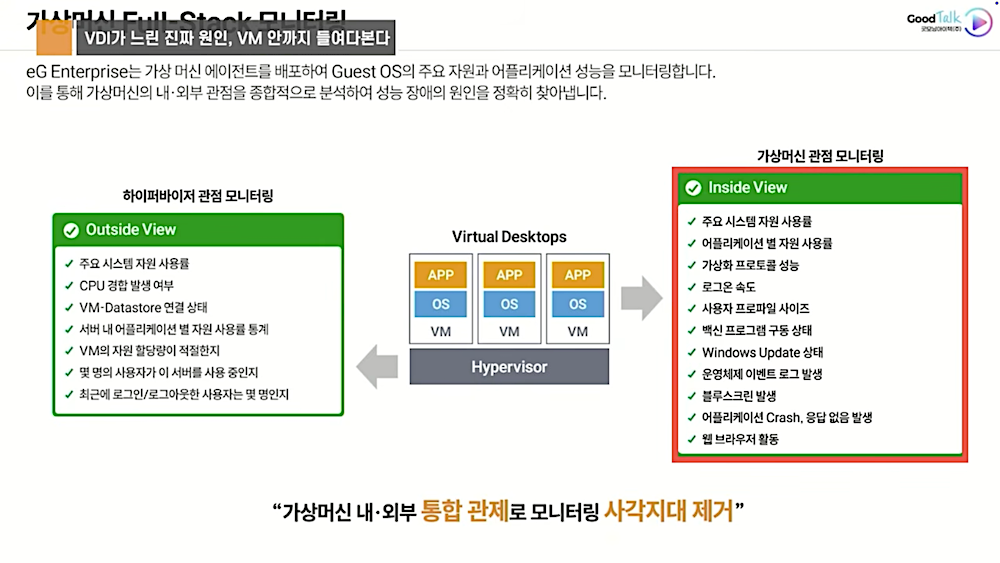
VDI 환경을 모니터링할 때 하이퍼바이저에서 보이는 VM의 상태만 확인해서는 실제 내부에서 어떤 문제가 발생하고 있는지 정확하게 판단하기 어려울 수 있다. 예를 들어 VM이 호스트의 CPU 자원을 할당받기 위해 기다리는 정도를 나타내는 ‘CPU Ready’ 지표가 높아졌다고 가정해 보자.
이 지표만 보면 호스트 서버의 CPU가 부족하다고 판단하기 쉽다.
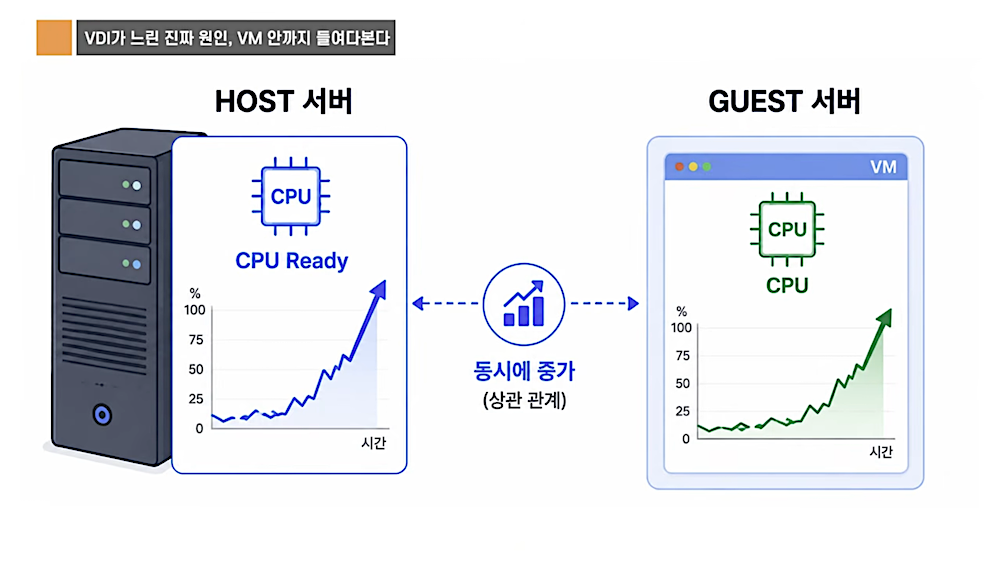
하지만 게스트 OS 내부의 CPU 사용률도 함께 증가하고 있다면 원인은 달라질 수 있다. 호스트의 자원 부족이 아니라 VM에 할당된 vCPU가 내부 애플리케이션의 실제 요구량을 감당하지 못하는 상황일 수 있기 때문이다.
따라서 장애를 정확하게 분석하려면 하이퍼바이저 지표뿐 아니라 게스트 OS 내부에서 어떤 프로세스가 실제로 자원을 사용하고 있는지까지 함께 살펴봐야 한다. 이처럼 VM 외부와 내부를 연결해서 보는 풀스택 모니터링이 필요한 이유다.
2. 사용자부터 스토리지까지 연결해야 장애의 ‘근본 원인’을 찾을 수 있다
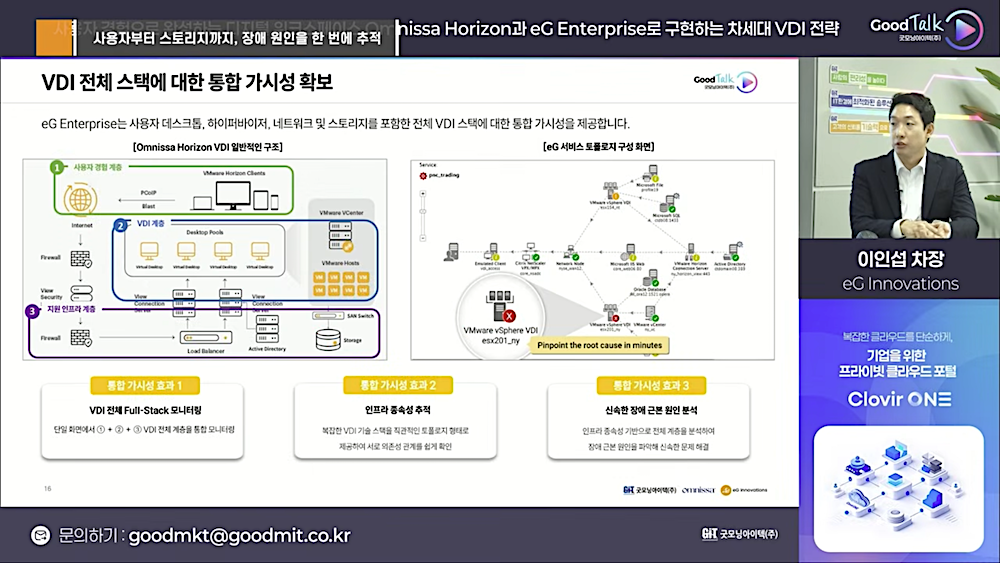
VDI는 하나의 시스템만으로 구성되지 않는다. 사용자의 접속 단말과 가상 세션이 있는 ‘사용자 경험 계층’, VDI의 핵심 시스템이 위치한 ‘VDI 계층’, 그리고 Active Directory·네트워크·스토리지 등으로 구성되는 ‘지원 인프라 계층’이 서로 연결되어 있다. 따라서 한 영역의 문제가 다른 영역의 장애처럼 나타날 수 있다.
잇(IT)터뷰에서 소개된 사례에서는 사용자가 웹페이지 로딩 속도가 느려지는 문제를 경험했다. 표면적으로는 웹서버나 애플리케이션 문제처럼 보일 수 있다. 일반적인 방식이라면 웹서버, 애플리케이션, DB, 가상화 서버 담당자들이 각각 자신의 영역을 확인하면서 원인을 찾아야 한다.
하지만 각 인프라의 종속 관계를 토폴로지 형태로 연결하고 계층 간 알람을 함께 분석하면 장애가 시작된 지점을 추적할 수 있다.
해당 사례에서 웹페이지 로딩 저하의 실제 근본 원인은 데이터스토어의 스토리지 공간 부족으로 인한 Oracle DB의 성능 저하였다. 결국 VDI 장애 대응에서 중요한 것은 각각의 알람을 따로 보는 것이 아니라 사용자 경험부터 애플리케이션, VM, 네트워크, DB, 스토리지까지 전체 기술 스택의 상관관계를 분석하는 것이다.
3. VDI 모니터링은 장애 대응뿐 아니라 인프라 비용도 줄일 수 있다
인프라 비용이 높아질수록 문제가 발생할 때마다 새로운 자원을 추가하는 방식에는 한계가 있다.
증설에 앞서 현재 보유한 자원 가운데 실제로 사용하지 않거나 필요 이상으로 할당된 자원이 있는지 먼저 확인할 필요가 있다.
잇(IT)터뷰에서는 사용자 세션 데이터를 분석해 일정 기간 동안 유휴 시간이 매우 높은 세션을 찾아 미사용 VM을 식별하는 사례를 소개한다. 또한 Right Sizing 분석을 통해 실제 사용량에 비해 CPU나 메모리 등이 과도하게 할당된 VM도 찾아낼 수 있다.
이렇게 발견한 미사용 VM의 자원을 회수하고 과도하게 할당된 자원을 적정 수준으로 조정한 뒤 필요한 곳에 다시 배치하면 추가 증설 없이 기존 인프라를 보다 효율적으로 사용할 수 있다.
즉 VDI 모니터링은 장애를 발견하기 위한 도구에 그치지 않는다. 실제 사용량을 기반으로 낭비되는 자원을 찾아내고 적절하게 재배치하는 인프라 최적화 수단으로도 활용할 수 있다.
4. 기존 VDI를 정확히 분석해야 새로운 환경으로 안정적으로 전환할 수 있다
VDI 플랫폼을 교체할 때도 기존 환경에 대한 분석이 중요하다. 기존 Citrix 환경에서 새로운 Omnissa Horizon 환경으로 전환한다고 해서 단순히 새로운 솔루션을 설치하는 것만으로 프로젝트가 끝나는 것은 아니다.
기존 환경에서 사용자가 실제로 어느 정도의 자원을 사용하고 있었는지, 어떤 성능 문제가 발생하고 있었는지, 과도하거나 부족하게 할당된 자원은 무엇인지 등을 먼저 파악해야 새로운 환경을 적절하게 설계할 수 있다. 새로운 VDI 환경을 설계하는 기간 동안 기존 Citrix 환경을 먼저 분석하고, 그 결과를 Horizon의 구성과 설계에 반영하는 방식을 소개한다. 기존 환경의 문제를 파악하지 않은 채 새로운 플랫폼으로 이전하면 이전에 존재했던 비효율이나 성능 문제가 새로운 환경에서도 반복될 수 있다.
반대로 기존 VDI의 사용량과 성능, 장애 이력을 분석해 새로운 환경의 설계 기준으로 활용하면 필요한 자원을 보다 정확하게 산정하고 잠재적인 문제도 미리 발견할 수 있다.
결국 VDI 전환은 단순한 솔루션 교체가 아니라 기존 환경을 진단하고 그 데이터를 새로운 환경의 설계에 반영하는 과정이 함께 이루어져야 한다.
5. 3줄 요약
– VDI 장애는 VM 하나의 지표만으로 판단하기 어렵기 때문에 사용자 경험부터 VM 내부, 애플리케이션, 네트워크, DB, 스토리지까지 연결해서 분석해야 한다.
– 풀스택 모니터링은 장애의 근본 원인을 빠르게 찾는 것뿐 아니라 미사용·과할당 자원을 찾아 인프라 비용을 최적화하는 데도 활용할 수 있다.
– 기존 VDI의 사용량과 성능 문제를 먼저 분석해 새로운 환경의 설계에 반영하면 VDI 플랫폼 전환 과정의 위험을 줄이고 안정적인 운영 환경을 구성할 수 있다.
◼ 전체 잇(IT)터뷰 내용은 ▶영상으로 바로 가기(클릭)◀에서 확인하실 수 있습니다. |
◼ 콘텐츠 & 웨비나 문의 : marketing@talkit.tv, 02-565-0012
Copyright ⓒ 토크아이티 All rights reserved. 무단 전재 및 재배포 금지.